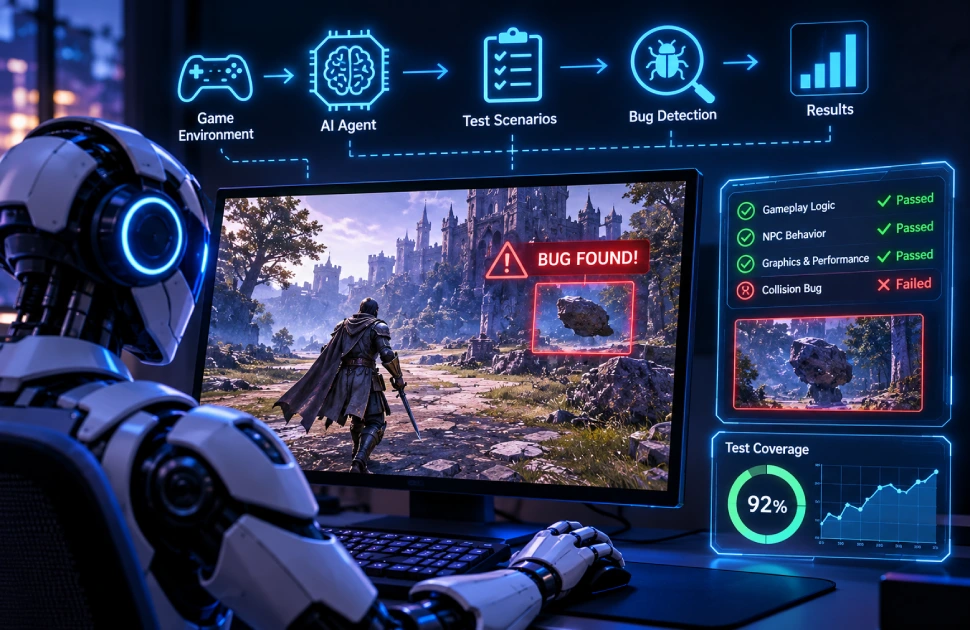
توسعه یک بازی ویدیویی مدرن فقط به طراحی مراحل، ساخت شخصیتها و پیادهسازی مکانیکهای گیمپلی محدود نمیشود. پیش از انتشار، هر بازی باید بارها و بارها آزمایش شود تا مشکلاتی مانند گیر کردن شخصیت در محیط، عملکرد نادرست ماموریتها، خطاهای فیزیکی، باگهای گرافیکی و اختلال در سیستمهای چندنفره شناسایی شوند. هرچه دنیای بازی بزرگتر و سیستمهای آن پیچیدهتر باشند، بررسی تمام حالتهای ممکن نیز دشوارتر میشود.
در این مقاله میخوانیم:
- چرا تست بازیهای ویدیویی به هوش مصنوعی نیاز دارد؟
- یادگیری تقویتی؛ هوش مصنوعی چگونه مثل بازیکن بازی میکند؟
- تجربه EA در استفاده از یادگیری تقویتی برای تست بازیها
- یادگیری تقلیدی؛ آموزش تستر هوشمند با مشاهده بازیکنان
- تست مبتنی بر مدل؛ بررسی منطق بازی پیش از اجرای سناریو
- عاملهای مبتنی بر مدلهای زبانی؛ وقتی AI هدف تست را میفهمد
- تشخیص باگهای گرافیکی؛ هوش مصنوعی فقط منطق بازی را بررسی نمیکند
- از آزمایشگاه تا استودیو؛ نمونههای عملی تست خودکار با AI
- محدودیتهای تست خودکار بازیها با هوش مصنوعی
- آینده تست بازیها؛ همکاری هوش مصنوعی و تسترهای انسانی
- منابع اصلی
نمایش بیشتر نمایش کمتر
در روشهای سنتی، بخش قابلتوجهی از این فرایند بر عهده تسترهای انسانی است؛ افرادی که ساعتها بازی میکنند، مسیرهای مختلف را امتحان میکنند و تلاش دارند شرایطی را به وجود بیاورند که ممکن است باعث بروز خطا شود. بااینحال، تکرار دستی یک سناریو در نسخههای مختلف بازی زمانبر است و حتی تسترهای باتجربه نیز ممکن است برخی از حالتهای غیرمعمول را نادیده بگیرند.
اینجاست که هوش مصنوعی میتواند نقش مهمی ایفا کند. سیستمهای تست خودکار مبتنی بر AI قادرند در محیط بازی حرکت کنند، تصمیم بگیرند، سناریوهای مختلف را امتحان کنند و در برخی موارد، بدون دریافت دستورالعمل دقیق برای تکتک حرکات، مسیرهای تازهای برای پیدا کردن مشکلات بسازند.
چرا تست بازیهای ویدیویی به هوش مصنوعی نیاز دارد؟
تست نرمافزارهای معمولی اغلب با ورودیها و خروجیهای مشخص سروکار دارد؛ اما بازیها محیطهایی پویا و تعاملی هستند. ممکن است بازیکن در یک مرحله چند مسیر متفاوت را انتخاب کند، با شخصیتهای مختلف تعامل داشته باشد، ترتیب انجام ماموریتها را تغییر دهد یا از مکانیکهای بازی به شکلی غیرمنتظره استفاده کند.
برای مثال، در یک بازی جهانباز (Open World)، بازیکن میتواند به منطقهای وارد شود که طراحان انتظار حضور او را در آن لحظه نداشتهاند. ممکن است ماموریتی را پیش از دریافت یک آیتم خاص آغاز کند، از یک مانع به روشی غیرمعمول عبور کند یا با ترکیب چند قابلیت، رفتاری پیشبینینشده ایجاد کند.
چنین شرایطی باعث میشود تست کردن صرفاً با اجرای چند مسیر از پیش تعیینشده کافی نباشد. سیستم آزمایش باید بتواند حالتهای مختلف بازی را بررسی کند و در صورت امکان، رفتارهای غیرمنتظره را نیز کشف کند.
مقاله «A Survey of AI-Driven Automated Game Testing Frameworks and Approaches» که در کنفرانس بینالمللی اتوماسیون و محاسبات IEEE در سال 2026 منتشر شده، چهار رویکرد مهم را در این حوزه بررسی میکند: یادگیری تقویتی، یادگیری تقلیدی، تست مبتنی بر مدل و روشهای ترکیبی اکتشافی. این رویکردها از نظر میزان سازگاری با تغییرات بازی، واقعگرایی رفتار، مقیاسپذیری و امکان استفاده در فرایند توسعه با یکدیگر تفاوت دارند.
یادگیری تقویتی؛ هوش مصنوعی چگونه مثل بازیکن بازی میکند؟
یکی از مهمترین روشها برای ساخت عاملهای هوشمند تست بازی، یادگیری تقویتی (Reinforcement Learning) است. در این روش، عامل هوش مصنوعی با محیط تعامل میکند، اقداماتی انجام میدهد و بر اساس نتیجه آنها بازخورد دریافت میکند. سپس تلاش میکند با تکرار تجربهها، رفتارهایی را یاد بگیرد که او را به هدف موردنظر نزدیکتر میکنند.
برای درک بهتر، یک بازی پلتفرمر را تصور کنید که در آن شخصیت باید از موانع عبور کند و به انتهای مرحله برسد. عامل هوش مصنوعی میتواند حرکت به چپ و راست، پرش و استفاده از قابلیتهای شخصیت را امتحان کند. اگر بتواند به بخش جدیدی از مرحله برسد، امتیاز دریافت میکند؛ اما اگر در یک مانع گیر کند یا سقوط کند، نتیجه آن در فرایند یادگیری ثبت میشود.
در تست بازی، هدف لزوماً تمام کردن مرحله نیست. توسعهدهندگان میتوانند برای رفتارهای خاص پاداش تعریف کنند؛ برای مثال، رسیدن به مناطق کمتر بررسیشده، امتحان کردن مسیرهای متفاوت، برخورد با اشیای محیط یا پیدا کردن موقعیتهایی که باعث اختلال در مکانیکهای بازی میشوند.
این روش بهخصوص برای کشف رفتارهایی مفید است که در تستهای از پیش نوشتهشده وجود ندارند. یک عامل آموزشدیده ممکن است ترکیب غیرمعمولی از حرکات را امتحان کند و به شرایطی برسد که طراحان بازی در ابتدا به آن توجه نکردهاند.
تجربه EA در استفاده از یادگیری تقویتی برای تست بازیها
یکی از نمونههای قابلتوجه استفاده از این فناوری، تحقیقات بخش SEED شرکت Electronic Arts است. پژوهشگران EA در سال 2020 روشی مبتنی بر یادگیری تقویتی عمیق (Deep Reinforcement Learning) را برای تقویت سیستمهای تست خودکار معرفی کردند.
هدف این سیستم، افزایش پوشش تست و کشف مکانیکهای ناخواسته، سوءاستفادههای احتمالی از سیستم بازی و باگهایی بود که ممکن است در جریان بازی عادی دیده نشوند. این پژوهش همچنین کاربردهایی مانند بررسی دشواری نقشهها و شناسایی مشکلات رایج در بازیهای تیراندازی اولشخص (FPS) را بررسی کرد.
EA در ادامه این مسیر، در پژوهشی دیگر به چالشهای انتقال عاملهای یادگیری تقویتی از محیط تحقیقاتی به فرایند واقعی تولید بازی پرداخت. این شرکت از ادغام یک سیستم آزمایشی مبتنی بر یادگیری تقویتی با ابزارهای تست خودکار موجود خبر داد؛ رویکردی که در مجموعهای از بازیهای AAA از جمله Battlefield 2042 و Dead Space (2023) بررسی شد.
اهمیت این تجربه فقط در توانایی عامل برای بازی کردن نیست؛ بلکه نشان میدهد استفاده از AI در محیط تولید واقعی به اتصال مناسب به ابزارهای توسعه، سازگاری با نسخههای مختلف بازی و مدیریت هزینههای آموزش و اجرا نیاز دارد.
یادگیری تقلیدی؛ آموزش تستر هوشمند با مشاهده بازیکنان
یکی دیگر از روشهای مهم، یادگیری تقلیدی (Imitation Learning) است. برخلاف یادگیری تقویتی که عامل با آزمونوخطا و دریافت پاداش رفتار مناسب را پیدا میکند، در یادگیری تقلیدی سیستم از نمونه رفتارهای انجامشده توسط یک بازیکن یا متخصص یاد میگیرد.
فرض کنید یک تستر انسانی مسیر مشخصی را برای بررسی یک ماموریت طی میکند. سیستم میتواند ورودیهای او، ترتیب حرکتها و واکنشهای بازی را ثبت کند و از این دادهها برای یادگیری رفتار مشابه استفاده کند.
این روش دو مزیت مهم دارد. نخست اینکه عامل برای رسیدن به یک رفتار پایه، مجبور نیست تمام مسیرها را از ابتدا و با آزمونوخطای طولانی کشف کند. دوم اینکه میتوان رفتارهای مفید تسترهای باتجربه را به سیستم منتقل کرد.
البته تقلید صرف از رفتار انسان محدودیتهایی دارد. اگر عامل فقط همان مسیرهای ثبتشده را تکرار کند، ممکن است در مواجهه با شرایط تازه عملکرد مناسبی نداشته باشد. به همین دلیل، ترکیب یادگیری تقلیدی با یادگیری تقویتی میتواند نتیجه بهتری ایجاد کند؛ ابتدا رفتار پایه از نمونههای انسانی آموخته میشود و سپس عامل با تجربههای جدید آن را بهبود میدهد.
در پژوهشی منتشرشده در سال 2026 با عنوان «Enhancing Automated Video Game Regression Testing through Behavior-Driven Development and Imitation Learning»، محققان رویکردی ترکیبی را بررسی کردند که مشخصات رفتاری نوشتهشده با زبان طبیعی را با یادگیری تقویتی و تقلیدی پیوند میدهد. این روش در یک نمونه بازی شبیه Super Mario Bros ساختهشده با موتور Godot ارزیابی شد.
تست مبتنی بر مدل؛ بررسی منطق بازی پیش از اجرای سناریو
همه روشهای تست خودکار به این شکل نیستند که هوش مصنوعی مستقیماً کنترل شخصیت را در دست بگیرد. در تست مبتنی بر مدل (Model-Based Testing)، ابتدا ساختار و قوانین بازی به شکلی قابلتحلیل تعریف میشوند. سپس سیستم بر اساس این اطلاعات، سناریوهای آزمایشی میسازد و بررسی میکند که آیا بازی مطابق انتظار رفتار میکند یا خیر.
برای مثال، در یک بازی نقشآفرینی، ممکن است ماموریتی تنها پس از دریافت یک آیتم و صحبت با شخصیت مشخصی فعال شود. مدل میتواند این پیششرطها و مراحل را ثبت کند. سیستم تست نیز بررسی میکند که آیا ماموریت در شرایط درست فعال میشود و آیا تغییر ترتیب اقدامات باعث ایجاد خطا خواهد شد یا خیر.
یکی از نمونههای این رویکرد در کنفرانس IJCAI 2025 معرفی شد. در این پروژه، پژوهشگران از روشهای برنامهریزی خودکار برای تست رگرسیون بازیها استفاده کردند.
در این سیستم، مهندس تست قوانین بازی را با زبان تعریف دامنه برنامهریزی (PDDL) مشخص میکند و وضعیت اولیه و هدف هر سناریو را تعیین میکند. سپس سیستم میتواند مسیر رسیدن به هدف را بهصورت خودکار تولید کند و در صورت تغییر شرایط، برنامه را دوباره تنظیم کند.
این ابزار با ویرایشگرهای موتورهای Unity و Unreal Engine نیز یکپارچه شده و اطلاعاتی مانند گزارش اجرا، دادههای Telemetry و ضبط ویدئویی را برای بررسی نتیجه تست جمعآوری میکند.
عاملهای مبتنی بر مدلهای زبانی؛ وقتی AI هدف تست را میفهمد
با پیشرفت مدلهای زبانی بزرگ (LLM)، رویکرد تازهای در تست بازیها شکل گرفته است. در روشهای قدیمیتر، عامل معمولاً مجموعهای از ورودیها را اجرا میکرد یا با توجه به پاداشهای تعریفشده به جستوجوی محیط میپرداخت. اما عامل مبتنی بر مدل زبانی میتواند دستورالعمل تست را به زبان طبیعی دریافت کند، وضعیت بازی را تحلیل کند و برای رسیدن به هدف تصمیم بگیرد.
برای نمونه، بهجای نوشتن یک اسکریپت طولانی برای بررسی یک ماموریت، میتوان هدفی مانند بازیکن باید ماموریت را بدون دریافت آیتم کلیدی به پایان برساند و سیستم نباید اجازه تکمیل آن را بدهد تعریف کرد. عامل باید وضعیت بازی را بررسی کند، اقدامات مناسب را انتخاب کند و در پایان نتیجه را با هدف موردنظر مقایسه کند.
پژوهشی با عنوان «Leveraging LLM Agents for Automated Video Game Testing» که در سپتامبر 2025 منتشر شد، چارچوبی به نام TITAN را برای تست هوشمند بازیهای MMORPG معرفی میکند.
این چارچوب چهار قابلیت اصلی دارد: درک و خلاصهسازی وضعیت پیچیده بازی، اولویتبندی اقدامات ممکن، استفاده از حافظه برای دنبال کردن وظایف طولانی و اصلاح تصمیمهای قبلی، و بهرهگیری از مدلهای زبانی برای تشخیص خطاهای عملکردی و منطقی.
پژوهشگران نمونه اولیه TITAN را روی دو بازی تجاری MMORPG در نسخههای رایانه و موبایل ارزیابی کردند. طبق نتایج گزارششده در مقاله، این سیستم به نرخ تکمیل وظیفه 95 درصد رسید و چهار باگ ناشناخته را شناسایی کرد که روشهای تست قبلی نتوانسته بودند آنها را پیدا کنند. نویسندگان همچنین از استفاده این چارچوب در هشت خط لوله واقعی تضمین کیفیت (QA) خبر دادهاند.
البته این نتایج مربوط به همان چارچوب و محیطهای آزمایششده هستند و نباید آنها را به تمام بازیها یا سیستمهای تست هوشمند تعمیم داد.
تشخیص باگهای گرافیکی؛ هوش مصنوعی فقط منطق بازی را بررسی نمیکند
یکی از مشکلاتی که ممکن است در بازیها رخ دهد، خطاهای دیداری یا باگهای بصری هستند. برای مثال، ممکن است بخشی از یک دیوار ناپدید شود، یک شخصیت درون محیط فرو برود، انیمیشن بهدرستی اجرا نشود یا شیئی در موقعیت نامناسبی ظاهر شود.
تشخیص این مشکلات برای تستر انسانی امکانپذیر است، اما بررسی هزاران فریم از گیمپلی زمان زیادی میبرد. در این زمینه، مدلهای یادگیری عمیق میتوانند تصاویر و فریمهای بازی را تحلیل کنند و الگوهای غیرعادی را شناسایی کنند.
پروژه AstroBug یکی از نمونههای پژوهشی این حوزه است. این سیستم از شبکه عصبی LSTM برای شناسایی ناهنجاری در فریمهای بازی استفاده میکند. فریمهایی که احتمال وجود خطا در آنها شناسایی میشود، سپس برای دستهبندی و بررسی بیشتر گروهبندی میشوند.
در نسخه توسعهیافته این چارچوب، یک عامل یادگیری تقویتی نیز برای جمعآوری خودکار دادهها به کار گرفته شد تا نیاز به حضور بازیکنان انسانی برای ثبت و مرور دستی محیط کاهش پیدا کند. این روش روی دو بازی تیراندازی اولشخص و یک بازی نقشآفرینی ارزیابی شد.
چنین فناوریهایی میتوانند به شناسایی خطاهای بصری کمک کنند، اما تشخیص هر ناهنجاری تصویری لزوماً به معنی وجود باگ نیست. برای مثال، یک افکت انفجار، نورپردازی غیرمعمول یا انیمیشن خاص ممکن است از نظر مدل متفاوت به نظر برسد، اما کاملاً بخشی از طراحی بازی باشد. به همین دلیل، نتیجه تحلیل هوش مصنوعی باید با قوانین بازی و بررسیهای تکمیلی تطبیق داده شود.
از آزمایشگاه تا استودیو؛ نمونههای عملی تست خودکار با AI
استفاده از عاملهای هوشمند برای تست بازی دیگر صرفاً به پژوهشهای دانشگاهی محدود نیست. شرکتها و توسعهدهندگان ابزارهایی را بررسی میکنند که بتوانند بخشی از فرایند تضمین کیفیت را خودکار کنند.
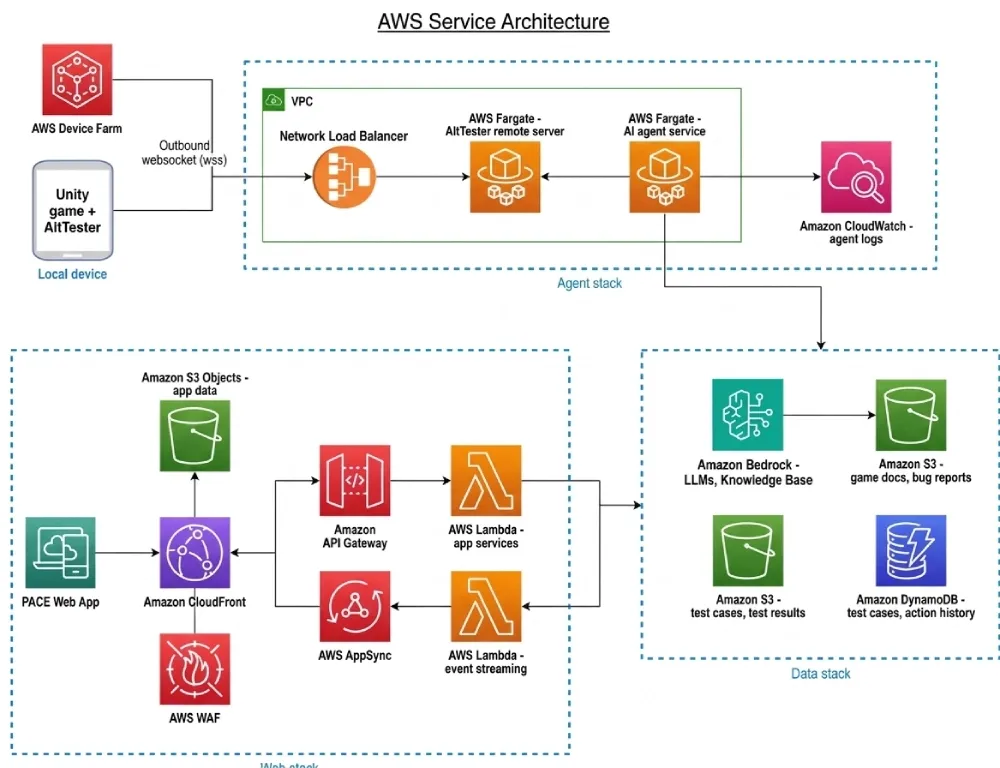
در ژوئیه 2026، AWS روشی برای ساخت یک عامل تست بازی مبتنی بر Amazon Bedrock معرفی کرد. این عامل به یک بازی ساختهشده با Unity متصل میشود، وضعیت محیط را دریافت میکند، سناریوهای تست را اجرا میکند و نتیجه را گزارش میدهد.
در این نمونه، عامل از طریق ابزارهای ارتباطی به ساختار داخلی اشیای بازی دسترسی دارد و میتواند اطلاعات لازم برای تصمیمگیری را دریافت کند. معماری معرفیشده شامل چرخهای از مشاهده وضعیت، استدلال، انتخاب اقدام و بررسی نتیجه است. این نمونه روی یک بازی استراتژی نوبتی موبایلی ساختهشده با Unity اعتبارسنجی شد.
نکته مهم در این رویکرد آن است که مدل زبانی بهتنهایی بازی را کنترل نمیکند؛ بلکه به ابزارهایی متصل میشود که امکان مشاهده وضعیت و اجرای اقدامات را فراهم میکنند. به این ترتیب، عامل میتواند دستورالعمل تست را به مراحل اجرایی تبدیل کند و گزارش قابلفهمتری از نتیجه ارائه دهد.
محدودیتهای تست خودکار بازیها با هوش مصنوعی
با وجود پیشرفتهای اخیر، استفاده از هوش مصنوعی در تست بازیها هنوز با چالشهای مهمی روبهرو است. یکی از اصلیترین مشکلات، هزینه محاسباتی و زمان موردنیاز برای آموزش عاملهاست. سیستمهای یادگیری تقویتی ممکن است برای یادگیری رفتار مناسب به تعداد زیادی تعامل با محیط نیاز داشته باشند؛ موضوعی که در بازیهای بزرگ و پیچیده میتواند پرهزینه باشد.
چالش دیگر، تعمیمپذیری (Generalization) است. عاملی که برای یک بازی یا حتی یک مرحله آموزش دیده، الزاماً نمیتواند در بازی دیگری با مکانیکهای متفاوت عملکرد خوبی داشته باشد. تغییر در رابط کاربری، قوانین بازی یا ساختار مراحل نیز ممکن است باعث شود سیستم به آموزش یا تنظیم مجدد نیاز پیدا کند.
تشخیص درست خطا نیز مسئله مهمی است. پیدا کردن یک رفتار غیرعادی بهتنهایی کافی نیست؛ سیستم باید بتواند تشخیص دهد که آیا این رفتار واقعاً باگ است یا بخشی از طراحی بازی. مدلهای زبانی نیز ممکن است در تحلیل وضعیت ناقص یا پیچیده دچار اشتباه شوند و گزارشی نادرست ارائه دهند.
در نهایت، ارزیابی عملکرد این سیستمها به معیارهای استاندارد نیاز دارد. برای مقایسه دو روش تست، تنها تعداد باگهای کشفشده کافی نیست؛ باید زمان اجرا، هزینه محاسباتی، میزان پوشش بخشهای بازی، نرخ خطای تشخیص و توانایی تکرار نتایج نیز در نظر گرفته شوند.
آینده تست بازیها؛ همکاری هوش مصنوعی و تسترهای انسانی
هوش مصنوعی قرار نیست در آینده نزدیک تمام وظایف تسترهای انسانی را بر عهده بگیرد. تسترها علاوه بر پیدا کردن خطاهای فنی، میتوانند کیفیت تجربه بازی، میزان سرگرمکنندگی، تعادل دشواری، خوانایی رابط کاربری و حس طبیعی بودن تعاملات را ارزیابی کنند؛ مواردی که سنجش دقیق آنها همچنان به قضاوت انسانی نیاز دارد.
در مقابل، عاملهای هوشمند برای انجام آزمایشهای تکراری، بررسی مسیرهای متعدد، اجرای سناریوهای طولانی و جستوجوی شرایط غیرمعمول مزیت دارند. ترکیب این دو میتواند فرایند تضمین کیفیت را سریعتر و گستردهتر کند.
در چنین مدلی، هوش مصنوعی بخش زیادی از تستهای تکراری و اکتشافی را انجام میدهد و نتایج مشکوک را برای بررسی دقیقتر در اختیار تیم QA قرار میدهد. تستر انسانی نیز میتواند زمان بیشتری را به بررسی تجربه واقعی بازیکن و تحلیل مشکلات پیچیده اختصاص دهد.
در مجموع، تست خودکار مبتنی بر هوش مصنوعی یکی از مسیرهای مهم تحول فرایند توسعه بازی است. از عاملهای یادگیری تقویتی که محیط را بهصورت مستقل کاوش میکنند تا مدلهای زبانی که سناریوهای تست را تفسیر و گزارش میکنند، این فناوری در حال تغییر شیوه شناسایی و بررسی مشکلات بازیهاست. بااینحال، رسیدن به سیستمهایی که در بازیهای بزرگ، متنوع و دائماً در حال بهروزرسانی قابلاعتماد باشند، همچنان به پیشرفت در تعمیمپذیری، کاهش هزینه و ارزیابی دقیق نیاز دارد.
منابع اصلی
1. A Survey of AI-Driven Automated Game Testing Frameworks and Approaches – IEEE, 2026
2. Building an AI Game Testing Agent with Amazon Bedrock – AWS
3. Technical Challenges of Deploying Reinforcement Learning Agents for Game Testing – EA
4. Using Planning for Automated Testing of Video Games – IJCAI, 2025
5. Leveraging LLM Agents for Automated Video Game Testing – 2025
هنوز دیدگاهی درباره این مقاله ذکر نشده است، شما اولین دیدگاه را درباره این مقاله بنویسید